En 2017, la fondation Mozilla a lancé Common Voice, une immense base de données d’enregistrements vocaux en open source qui permet à n’importe qui d’entraîner des applications interagissant avec la voix. Mozilla a défini qu’un jeu de données d’au moins 10 000 heures étaient nécessaires pour s’assurer de la qualité des applications. 2 400 heures de données vocales sont d’ores et déjà disponibles en 28 langues. Pour toucher son objectif, la fondation encourage les internautes et les entreprises à donner de leur voix pour enrichir cette base de données. A terme, Common Voice devrait aider Mozilla à mettre au point un moteur de recherche vocal. Explications avec Alexandre Lissy, DeepSpeech Senior Research Engineer chez Mozilla.
 Alexandre Lissy, DeepSpeech Senior Research Engineer chez Mozilla © SA Ludovic Hirlimann 2012
Pouvez-vous nous en dire plus sur le projet Common Voice lancé par Mozilla ?
Common Voice est une base de données sous licence libre pour permettre à tout à chacun de développer une application basée sur la voix. Nous mettons à disposition des enregistrements audio et leur retranscription textuelle exacte. Cette matière première permet de faire du machine learning et de l’apprentissage profond. Cette idée nous est venue lorsque nous avions travaillé sur l’élaboration d’un assistant vocal pour Firefox OS. Nous avons alors remarqué que certains langages n’étaient pas bien fournis en jeux de données. Or, nous en avions besoin pour entraîner cet assistant vocal. C’est là que nous avions pris conscience de l’importance d’une telle base de données. La première version de Common Voice est sortie en anglais en juin 2017. Chaque communauté est en charge de construire et d’animer la contribution sur sa langue depuis juin 2018. Nous avons déjà collecté plusieurs centaines d’heures en français et l’allemand par exemple.
Votre but est-il de contrebalancer l’hégémonie des GAFA qui, à travers leurs assistants vocaux, possèdent une multitude de données pour entraîner leurs algorithmes ?
Ce projet s’inscrit dans l’ADN de la fondation Mozilla qui est de défendre un Web accessible et ouvert à tous. Demain, la recherche vocale sera un point d’entrée majeur vers le Web. S’il n’existe pas de solution libre, il y a aura donc une restriction de l’accès au Web. Il faut laisser la possibilité à de petits acteurs d’accéder à la technologie vocale. Dans notre démarche, il y a aussi la volonté de conserver certains langages moins répandus, comme certaines langues régionales par exemple.
Comment une entreprise peut-elle profiter des données que vous mettez à disposition ?
Il suffit de renseigner son adresse e-mail pour pouvoir être contacté. L’utilisateur a alors accès à un fichier TSV et un fichier MP3 qui correspond. Il peut également obtenir des métadonnées qui en disent plus sur le profil de la personne qui a prêté sa voix : âge, genre, éventuel accent. Nous demandons aux utilisateurs de ne pas chercher à identifier une voix à partir de ces métadonnées. Le but du projet est que tout reste anonyme. Le fait d’avoir plusieurs tonalités de voix permet d’humaniser les appareils vocaux.
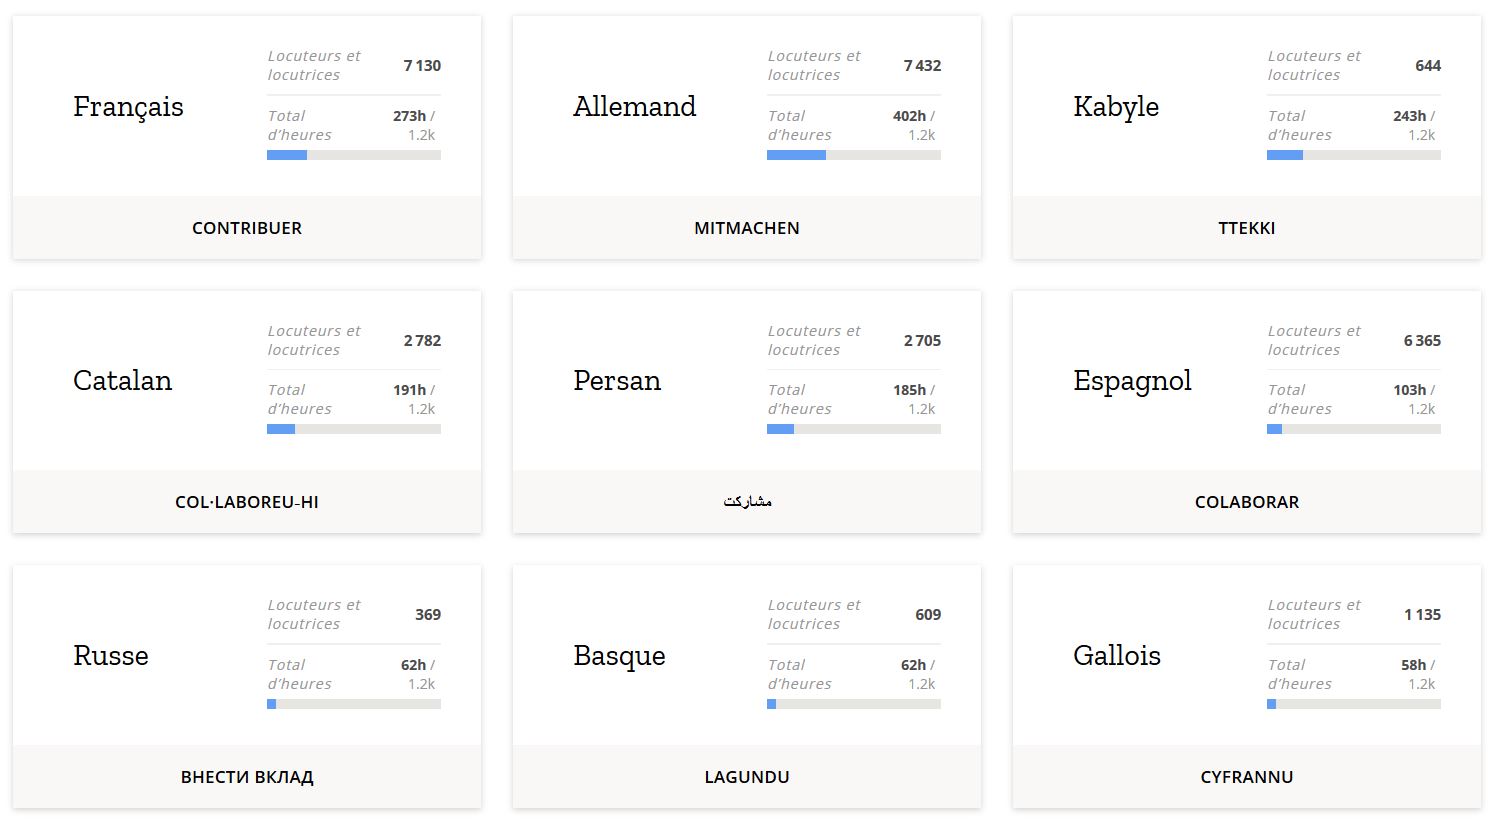 Etat actuel des "dons" de voix
Photo d'ouverture : Thomas Le


 Alexandre Lissy, DeepSpeech Senior Research Engineer chez Mozilla © SA Ludovic Hirlimann 2012